セミナー動画の「えー」をAIで自動カット・書き出しする仕組みを作った
kickflow Biz-AX Journal編集部です。
本サイトは、「株式会社kickflowのビジネス系AX(AI活用)を赤裸々に公開する」をミッションとしたブログです。
ブログを立ち上げた背景は、以下の記事もぜひご覧ください。
https://kickflow.com/ax-journal/puf1oo65lxdk
本記事では、タイトルの通り「セミナー動画の「えー」をAIで自動カット・書き出しする仕組み」の話をします。
取り組みの概要
kickflow のマーケティングチームでは、ウェビナーの録画を編集して公開しています。
この記事では、その編集のうちフィラーと間のカットを自動化した過程をつまずいた点も含めて紹介します。
- 使ったツール:Claude Code(作業の指示と実装)、Gemini API(音声の書き起こしと確認)、ReazonSpeech の日本語音声認識モデル(時刻合わせ)、ffmpeg(動画の切り出しと書き出し)
- 試した動画:セミナー動画2本(20分と26分の録画素材)
第1章|動画編集の時間はどこにかかっていたのか
ウェビナーの録画をそのまま公開すると、話し言葉特有のフィラーや、画面切り替えの待ち時間がそのまま残ります。
リアルタイムで聞いている分には気にならなくても、録画で見返すと間延びして感じられます(なんなんでしょうね、この間隔の違い)。
なので、最近は必ず編集を入れて、フィラーや冗長な表現を可能な限り削ったうえでアーカイブ動画として公開をしています。
実際、フィラーを取り除いて間を詰めた動画は、同じ内容でもかなり見やすくなりました。
このことから、録画を公開するなら、リアルタイム配信にこだわらず編集した版を出すほうがよいと考えるようになりました。
あるいは、セミナー自体も事前収録しておいた方が本当に"伝わる"のではないか、とも思い始めています。
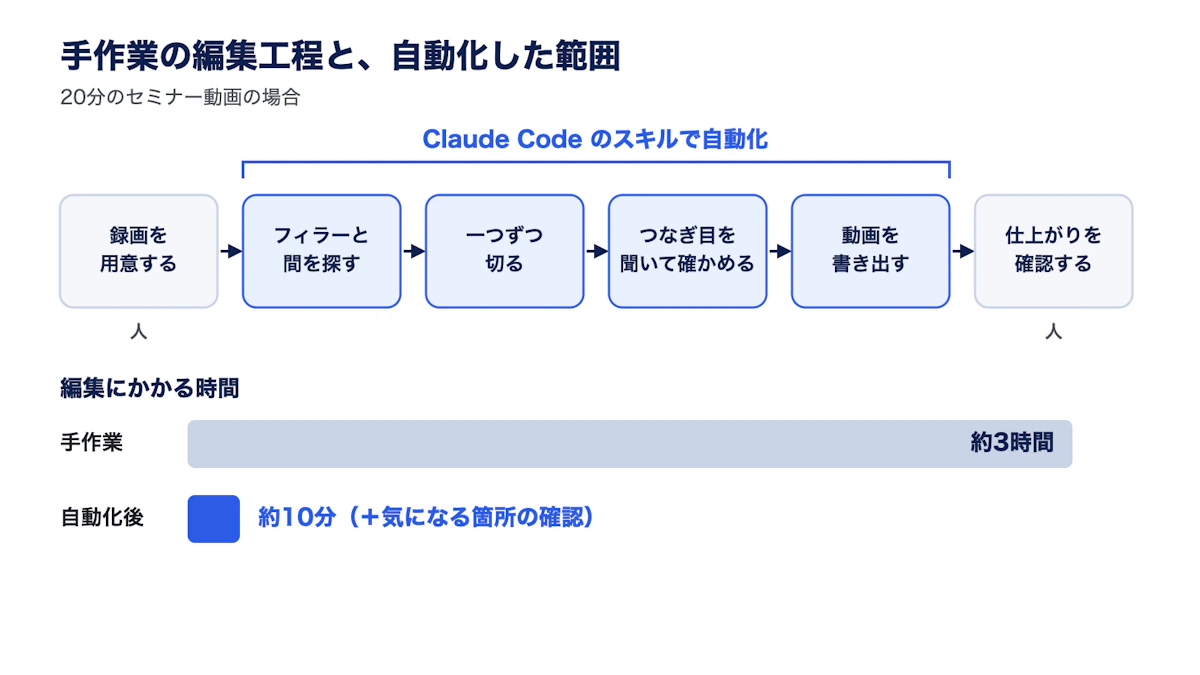
問題はその準備の手間です。 20分ほどのセミナー動画でも、フィラーを一つずつ探して切る作業とその確認に最低でも3時間ほどかかっていました。
フィラーは1分に数回のペースで出てくるので、毎回の作業時間が積み上がっていきます(話をもっとうまくできるようになりたいものです)。
第2章|会議録ツールの文字起こしでは切れなかった理由
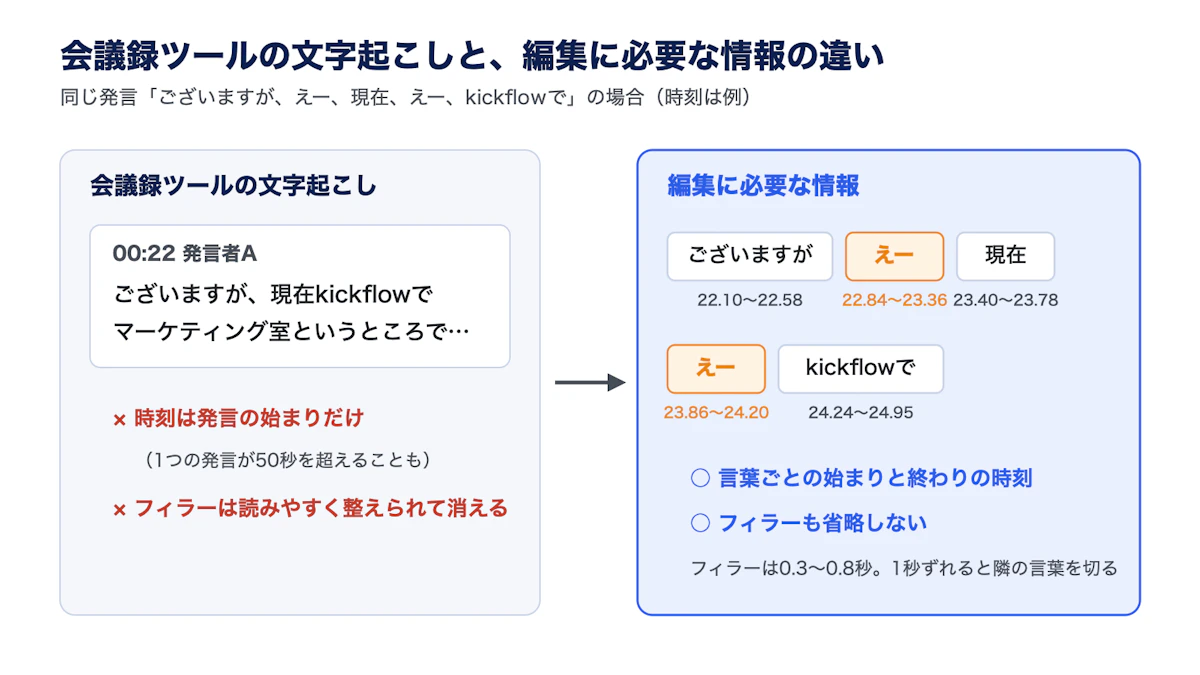
最初に検討したのは、社内で使っている会議録ツール(Circleback)の文字起こしを使う方法です。
ところが、実際の文字起こしを確認すると、フィラーを切る用途には二つの点で合いませんでした。
時刻が発言単位でしか付いていない
文字起こしの時刻は、発言の始まりにしか付いていませんでした。
一つの発言が50秒以上続くこともあり、その中のどこにフィラーがあるかまでAIは判定してくれませんでした。
フィラーが読みやすく整えられている
もう一つは、フィラーそのものが文字起こしからほとんど消えている?ということです。
35分の会議の文字起こしで、残っていた「えーと」「あのー」は数か所だけでした。
おそらく自動でフィラーを取り除いていると考えられます。
録画としては望ましいですが、文字起こしに残っていないとAIは判定してくれませんでした。
第3章|生成AIに時刻を聞いても合わなかった理由
次に、音声を Gemini に渡して「フィラーの位置を秒単位で返して」と頼む方法を試しました。
想定以上にフィラーを拾ってくれ、「えー、あのー も省略せずに書き起こして」と指示すれば短い「え」まで拾ってくれます。
ところが、返ってくる時刻がずれていました。
1回に送る音声が1分を超えたあたりから、後半ほど実際より後ろの時刻を返すようになり、2分の音声に対して「157秒」と答えることもありました。
フィラーの長さは0.3秒から0.8秒ほどしかないケースがほとんどです。
時刻が1秒ずれれば、フィラーではなく隣の言葉を切ることになります。
音声を30秒ずつに区切って送るとずれは小さくなりましたが、それでも言葉を削らずに切れる精度には届きませんでした。
第4章|文字はAIに、時刻は手元のモデルに任せる
ここまでの試行で、Gemini は「何を言ったか」には強く、「いつ言ったか」には弱いことが分かりました。
そこで、役割を分けました。
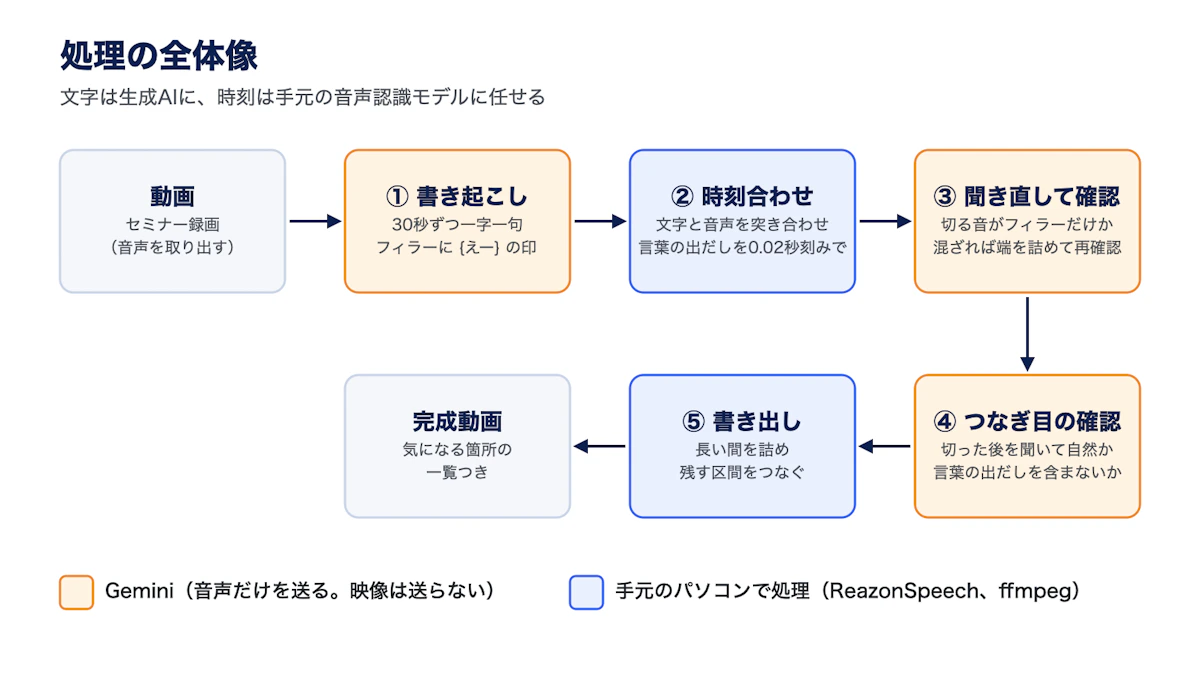
文字の書き起こしは Gemini に任せ、時刻は手元で動く日本語の音声認識モデルで合わせます。
フィラーに印を付けて書き起こす
まず Gemini に、音声を30秒ずつ一字一句書き起こしてもらいます。
このとき、フィラーだけを {えー} のように括弧で囲むよう指示します。
これで、文章のどこにフィラーがあるかが文字の上で分かります。
文字と音声を突き合わせて時刻を出す
次に、書き起こした文字と元の音声を、手元の音声認識モデル(ReazonSpeech の wav2vec2)で突き合わせます。
この処理は文字列が音声のどの位置に当たるかを0.02秒単位で求められるそうです。すごい!
処理はすべて手元のパソコンの中で完結します。
ただし、このモデルには癖がありました。
テレビの字幕で学習しているため、字幕に書かれないフィラーをほとんど聞き取らないとのことでした。
そのため、フィラーの文字そのものの時刻は当てになりません。
一方で、前後の普通の言葉の時刻は正確でした。
そこで、フィラーの位置を「直前の言葉の終わりから、直後の言葉の出だしまで」の範囲としました。
切る前にもう一度聞いて確かめる
時刻が分かっても、すぐにはカットとはなりませんでした。
カットする予定の短い音を Gemini に聞かせ直し、フィラーだけでできているかを確かめます。
「えー、き」のように次の言葉の頭が混ざっていれば、混ざった側の端を0.06秒ずつ詰めて、もう一度確かめる工程を挟みました。
つなぎ目まで聞いて確かめる
最後に、カットした後のつなぎ目の前後1.2秒を実際につないで聞かせ、不自然に途切れていないかを確かめます。
加えて、カット範囲に普通の言葉の出だしが入っていないかを、手元の時刻合わせの結果で照合します。 どれか一つでも引っかかれば、そのフィラーは切りません。
長い間は別に処理します。 0.6秒を超える沈黙は、話し終わりの後に0.25秒、話し始めの前に0.12秒を残して詰めています。
語尾の「す」は息だけの小さな音になりやすく、無音と区別しにくいため、話し終わりの後を長めに残しています。
第5章|切る数を増やすと何が起きるか
確認を緩めれば、もっと多くのフィラーを切ってくれます。
実際、確認の一部を外した版では、20分の動画で147件のフィラーを切ってくれました。
ただ、その版を聞き直してみると、約20か所で言葉が欠けていました。
欠け方には、いくつかのパターンがありました。
- 「AI(エーアイ)」の「エー」を、フィラーの「えー」と区別できずに切っていた
- 「これ」が「こ」で途切れていた
- 範囲を何度もずらして聞き直すうちに、言葉の切れ端がたまたまフィラーに聞こえた位置で切っていた
最後のパターンは、聞き直すたびに「こういう」「保有」「ゆ」「ゆう」「えっと」と聞こえ方が変わっていき、最終的にフィラーと判定されてしまったものです。
AIも、短い音の切れ端だけを聞かされると、人と同じように聞き間違えるようです。
言葉が欠けた動画は、フィラーが残った動画よりも、視聴者に与える印象が悪くなります。
なので、確認をすべて入れた版を採用しました。
確認を緩めた版 | 採用した版 | |
|---|---|---|
切ったフィラー | 147件 | 63件 |
つなぎ目の近くの不自然な箇所 | 約20か所 | 4か所 |
その代わり、フィラーは全部は取り切れていません。 元の動画にあった約158件のうち、切れたのは63件です。
見送りの一番多い理由は、フィラーが「えー現在」のように次の言葉と切れ目なくつながっていることでした。
こうしたフィラーは、言葉を削らずに切ること自体が難しいようです(ここはAIより先に、話す側が頑張るしかなさそうです…)。
第6章|スキルにして、頼むだけで動くようにする
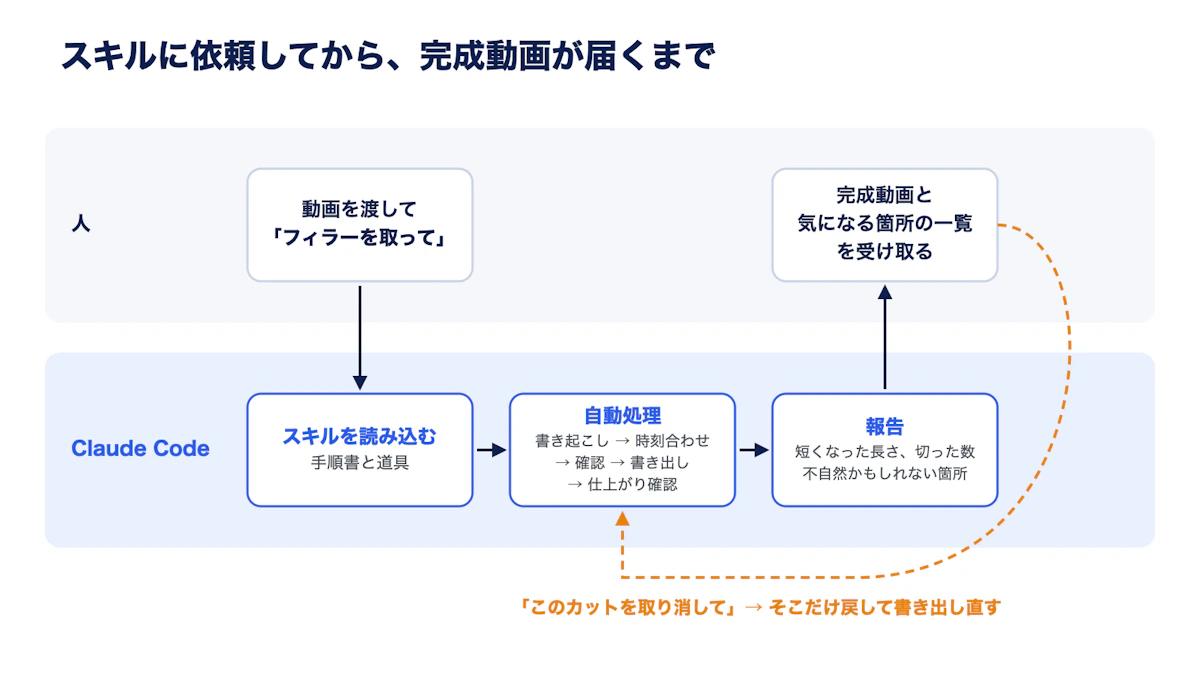
仕組みが固まったところで、Claude Code のスキルにまとめました。
スキルは、手順書とスクリプトをひとまとめにしたもので、関連する依頼を受けると Claude Code が自動で読み込んで使ってくれます。
なので、動画ファイルを渡して「この動画のフィラーを取って」と頼むだけで、確認から書き出しまで進めてくれます。
スキルがちゃんと動くかは、作った会話とは別の、スキルの中身を何も知らないエージェントに手順書だけを渡して確かめました(AIにAIのテストをしてもらう形です)。
26分のウェビナー録画で最後まで迷わずに進み、25.8分の動画が22.4分になりました。 画質はほとんど変わらず、音ズレもありませんでした。
このテストでは、改善点も見つかりました。 一番大きかったのは、不自然なカットを一つだけ元に戻す手段がないことです。
仕上がりの確認でAIが指摘した箇所も、最終的には人が聞いて判断したい場面があります。
そこで、指摘された時刻を伝えれば、そのカットだけを取り消して書き出し直せるようにしました。
なお、この仕組みは動画の音声を Gemini API に送ります(映像は送りません)。
社外の方が話している動画や、社外秘の内容を含む動画では、送ってよいかを事前に判断する必要があります。
まとめ
今回の取り組みで分かったことをまとめます。
- 「何を言ったか」と「いつ言ったか」を分けて扱うことで、精度が上がりました。文字は生成AIに、時刻は手元の音声認識モデルに任せています。
- 生成AIの音声のタイムスタンプは、長い音声ほどずれていくようです。30秒程度に区切ると実用的になりました。
- フィラーを多く切るほど、言葉が欠けやすくなります。確認できたものだけを切る方針で、20分の動画が約2分短くなりました。
- スキルにまとめたことで、編集は「動画を渡して、仕上がりを確認するだけ」になりました。
フィラーの自動カットに限らず、AIで業務を自動化するときは、AIが得意な部分と苦手な部分を分けて、苦手な部分を別の手段で補う、という考え方が効きました。
手元に編集待ちの録画があれば、まず1本、フィラーの数と編集にかかっている時間を数えるところから始めてみてください(3時間かかっていた作業が10分で終わるのは、本当にうれしいです)。
この号はここまでです。
マーケAX をもっと読む